 @ (주)GS
2024풀스택
AI Agent 플랫폼 - (주)GS
플랫폼 런칭 • 워크플로우 빌더 • AX 교육 = 자율 운영 완성
자세히 보기
VOC가 죽은 데이터로 쌓이던 환경을, 통합 분석 시스템으로 0에서 빌딩한 사례.
주어진 미션은 한 줄이었다. 들여다보니 분류기 정확도는 가장 작은 문제였다 — 앱·콜·설문·SNS 네 채널이 각자 다른 곳에 쌓였고, 입력에는 "hhhhhh" 같은 가비지가 분류기까지 흘러갔으며, CS팀은 매주 수천 건을 수작업으로 다시 분류하며 시스템 부재의 비용을 사람으로 메우고 있었다.
분류기 하나를 잘 만드는 게 아니라, 수집 → 정제 → 분류 → 액션까지 잇는 선순환 구조를 0에서 빌딩해야 했다. 이게 프로젝트의 진짜 시작점이었다.
관찰 노트
통합 수집이 없었다
앱·콜·설문·SNS 4채널이 각자 다른 곳에 쌓이고 있었다
분류기 앞에 게이트가 없었다
"hhhhhh"·"ㅋㅋ"·빈 문자열이 60카테고리까지 그대로 흘러왔다
사람이 시스템을 떠받치고 있었다
CS가 매주 수천 건을 수작업으로 재분류하고 있었다
tradeoff한국어 토픽 정확도 vs API 비용
"객관 분류 페르소나" 시스템 프롬프트로 LLM 의 hallucination 을 차단했다. 가스라이팅 패턴으로 이전 turn 영향도 끊었다.
가비지 텍스트는 LLM 도달 전에 정규식·길이 룰로 제거. 불필요한 API 호출 30% 절감 + 정확도 추가 확보.
벡터 임베딩 + 토픽 매칭으로 60카테고리를 6의도 × 10세부로 재구조화. 검색 가능한 분석 자산으로 전환.
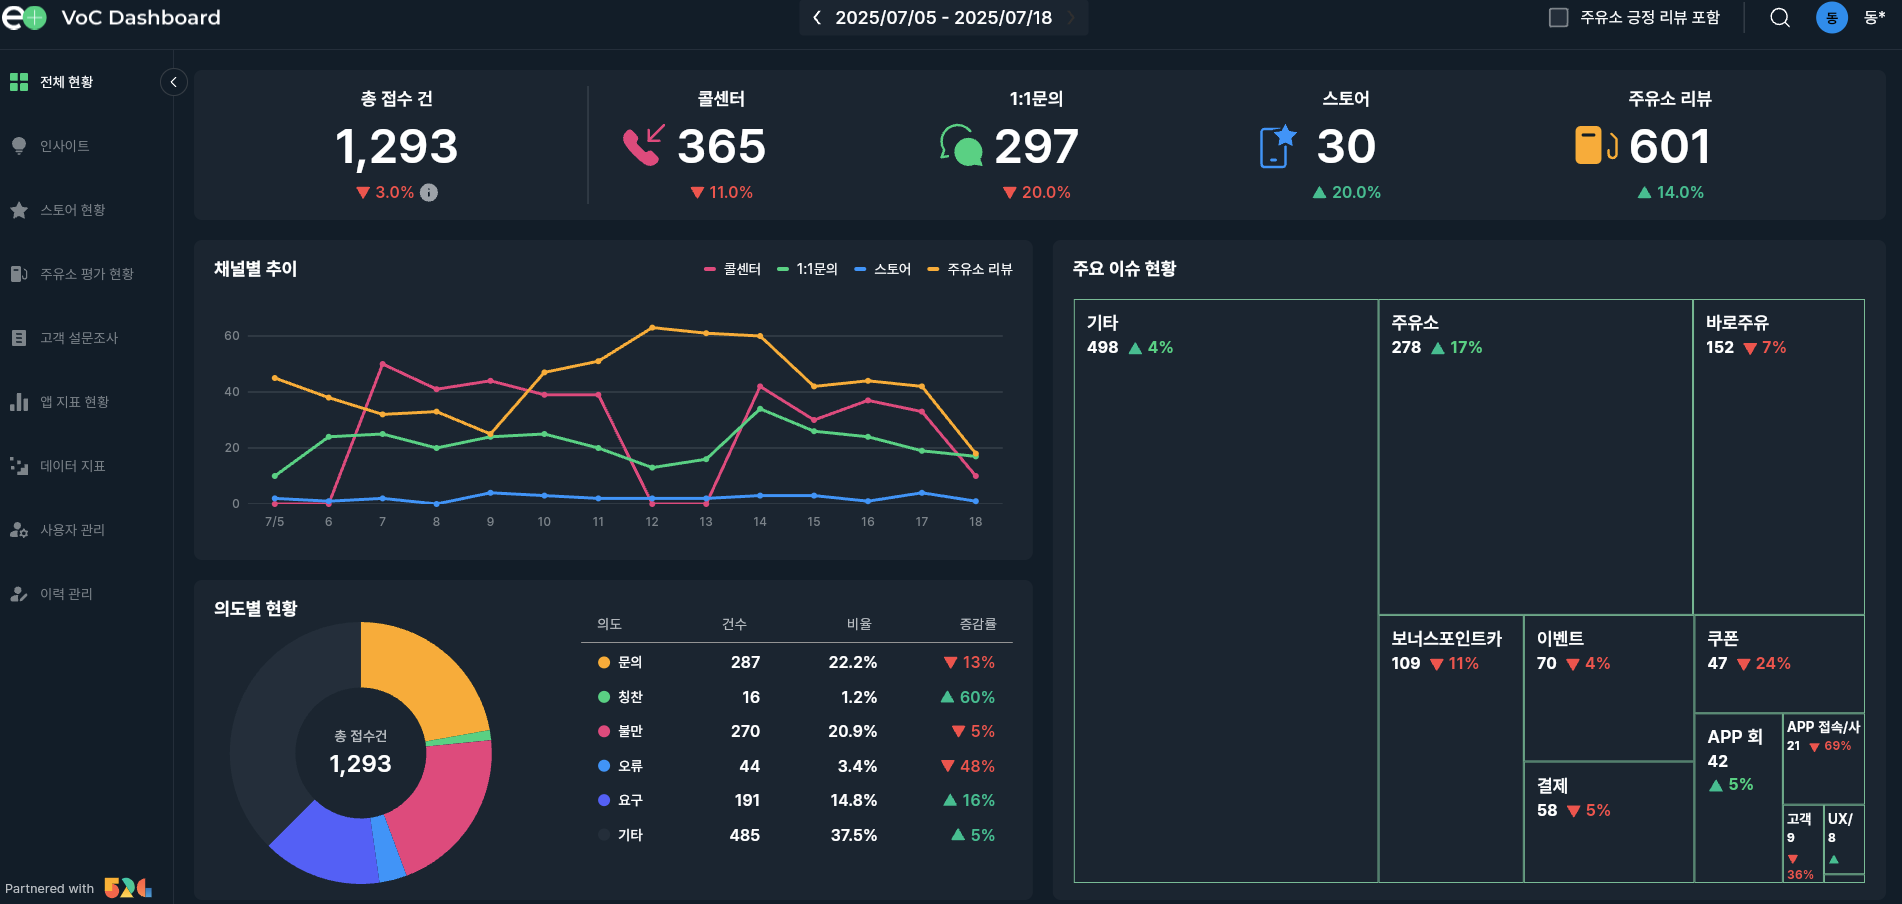
수작업 → 자동
0 → 1000+
CS 분류 / day
토픽 정확도
70 → 88%
+18pp
자동 수집 채널
4채널
앱 · 콜 · 설문 · SNS
API 비용
−30%
전처리 룰로 가비지 차단
“지표를 직접 잡고, 비용·정확도 트레이드오프를 스스로 결정하며, AI 를 사고 도구로 쓰는 엔지니어.”
운영 데이터에서 60카테고리의 모호함을 패턴으로 짚어냄
LLM 모델 비교·전환 + 프롬프트로 정확도 +18pp
CS 수작업 0 → 자동 1000+/day, API 비용 30%↓